视频基础模型能力
按视觉、时间、语义、控制和行动等维度描述模型能力,并区分能力、训练方法与产品功能。
前置知识: 视频生成基础。
使用步骤: 确定需要测量的能力 → 选择对应任务和指标 → 区分基础模型、后训练模型与完整系统的结果。
基本概念:物理一致性是模型输出和行为层的能力;后训练是获得、增强或重塑能力的机制。 如果要描述基础模型是否“容易后训练”,更准确的能力名称是可适配性 / 可对齐性,而不是“后训练能力”。Foundation model 的核心判据本来就是广泛预训练后可适配多类下游任务,而非是否采用某一种训练算法 [1]。
章节接口: C1–C9 的定义在本章维护;任务分类维护输入输出,生成原理维护机制,系统章维护集成与归因,评测维护能力证据。导航将本章归入分类索引。
1. 能力、任务、训练与系统属性
同一个概念只有先放对轴,后续章节才不会把“模型会什么”和“怎样训练模型”混成一棵树。
| 轴 | 回答的问题 | 例子 | 不应混入 |
|---|---|---|---|
| 能力 | 模型或系统会什么? | 时间一致、条件遵循、物理一致、动作响应 | SFT、DPO、蒸馏 |
| 任务 / 接口 | 能力通过什么输入输出规格被调用? | T2V、I2V、V2V、视频编辑、动作条件预测 | 把任务名直接当成内部能力 |
| 获得方式 | 能力在什么阶段、用什么信号形成? | 预训练、CPT、SFT、偏好优化、RL、测试时引导 | 把使用某算法等同于获得某能力 |
| 系统属性 | 在什么成本、风险与服务条件下运行? | NFE、延迟、显存、流式、安全、来源与 API | 把 4K、低延迟或过滤器归因给 base checkpoint |
例如,“物理一致性”回答的是输出是否遵守世界规律,属于能力轴;“VideoDPO”回答的是如何用偏好对更新生成器,属于获得方式;“文本到视频”是任务接口;“4 秒首帧延迟”则是系统属性。
1.1 跨表格索引
能力地图是 C1–C9 的唯一释义入口,其他页面只引用编号,不重复定义。可以沿下面五张主表完成“能力 → 任务 → 获得方式 → 证据 → 应用/系统”的追踪:
| 要继续回答的问题 | 对应主表 | 两张表怎样连接 |
|---|---|---|
| 哪些任务会调用这项能力? | 任务—能力矩阵 | 每项任务都链接到其主要 C 编号 |
| 哪种后训练可能改善它? | 后训练—目标能力矩阵 | 训练路线只表示常见目标,不保证能力提升 |
| 应该用什么实验验证? | 能力—评测矩阵 | 每种评测单位对应可支持的能力声明 |
| 真实场景需要组合哪些能力? | 应用—能力矩阵 | 能力标签与任务接口、系统组件分列 |
| 结果应归因给 checkpoint 还是系统? | 系统归因矩阵 | 能力声明必须落到可核验的模型或系统单位 |
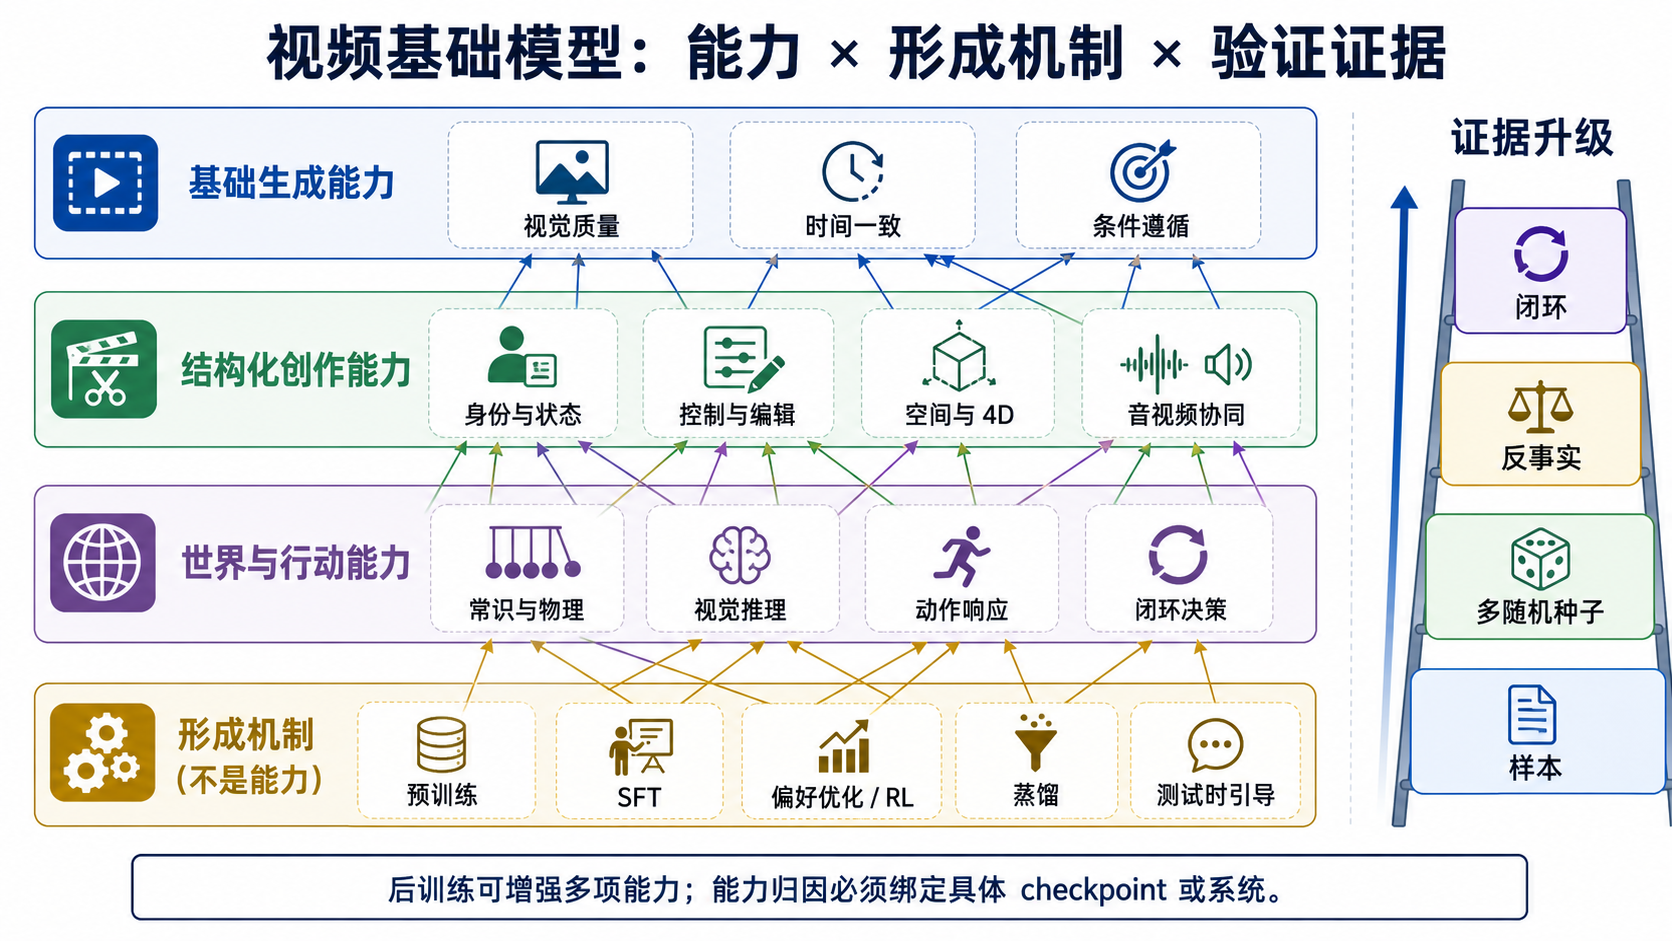
图 1:能力与形成机制是多对多关系。 同一种后训练方法可改善多项能力,也可能让某些能力退化;同一项能力又可由预训练、结构条件、后训练或外部验证闭环共同提供。图中的箭头表示可能的影响,不表示固定流水线或因果保证。
2. 能力分类
VBench 将早期生成质量拆成视觉质量、时间一致和条件一致等维度 [2];VBench-2.0 又把 Human Fidelity、Controllability、Creativity、Physics 与 Commonsense 作为更深的 intrinsic faithfulness 维度 [3]。UniVBench 则从统一模型的任务表面归纳理解、生成、编辑和重建四类操作 [4]。三者观察角度不同:前两者偏向输出属性,后者偏向任务接口。本页不直接照搬任一 benchmark,而将可跨任务复用的行为整理成 C1–C9。
2.1 基础生成能力
T2V-CompBench 对组合条件的细分说明,名词命中与正确绑定不是一回事 [5]。同样,长时能力的单位不应只是“生成了多少秒”,而应看人物、道具、场景和事件状态能否跨时间继续成立。
2.2 结构化创作能力
SV4D 2.0 表明多视角与时间一致需要联合的 view–time 验证,而不能被一条相机路径替代 [6]。VABench 则把同步音视频进一步拆为跨模态语义、事件同步、口型与立体声等维度 [7]。对应任务与方法见细粒度可控生成、视频编辑、个性化视频、多视角与 4D和原生音视频。
2.3 世界理解与行动能力
物理一致性本身还应分三级:表面运动合理 → 指定规律下结果正确 → 干预后的因果差分正确。PhyGenBench 和 VideoPhy-2 能诊断具体可见规律,但仍不能代替动作反事实或决策实验 [8] [9];WorldModelBench 也主要评价指令、常识与可见物理违规 [10]。完整证据阶梯见物理一致性。
生成模型也开始表现出零样本感知、视觉操作和问题求解行为 [11]。这些结果支持把 C8 纳入研究地图,但黑盒 prompt rewriter、best-of-\(k\) 和外部 judge 都可能贡献结果,因此应写成“生成式视觉推理行为”,而不是直接声称已解释内部机制。动作世界模型则需要更强证据;V-JEPA 2 把 action-free 表征、动作条件 predictor 与规划分开,正说明能力必须归因到具体模块 [12]。
3. 任务与能力的对应关系
| 任务表面 | 通常调用的能力 | 仍需单独声明的规格 |
|---|---|---|
| T2V | C1 · C2 · C3 · C7;复杂控制还需 C5 | 条件来源、seed、时长、拒绝与重试 |
| I2V | C1 · C2 · C3 · C5 · C7 | 锚点时刻、参考保持、运动自由度与多未来 |
| 视频编辑 / 个性化 | C2 · C3 · C5 | 哪些内容必须改变,哪些必须保持 |
| 多镜头故事 | C1 · C2 · C3 · C4 · C5 · C7 | 镜头计划、实体账本、不可逆事件和回滚 |
| 原生音视频 | C1 · C2 · C3 · C6 · C7 | 两个模态是否联合采样,还是后配音 |
| 多视角 / 4D | C1 · C3 · C4 | camera–time 网格、输出是像素还是可查询状态 |
| Video Reasoning | C2 · C3 · C7 · C8 | 答案、过程、预算和外部工具 |
| 动作条件预测 / 交互世界 | C3 · C4 · C7 · C9;含显式规划或推理时再加 C8 | 动作空间、反馈频率、horizon、闭环环境 |
因此,T2V、I2V 或 V2V 适合放在任务地图,Diffusion、Flow、AR、SFT 或 RL 适合放在生成模型路线,C1–C9 才是“模型会什么”的统一入口。
4. 后训练与可适配性
后训练是横向能力增强机制。它只说明在预训练 checkpoint 之后又发生了优化,不说明优化了哪项能力,也不保证所有能力同时上升。
| 路线 | 直接改变谁 | 常见能力目标 | 不能自动声称 |
|---|---|---|---|
| continued pretraining / SFT | generator 权重 | 领域覆盖、条件遵循、镜头语言、某类控制接口 | 有偏好对齐、物理推理或更少采样步数 |
| reward model | 独立评价器 | 学会评价质量、运动、语义、物理或安全 | RM 训练完成就改善 generator |
| DPO / RWR / policy-gradient RL | generator 或 prompt policy | 偏好、运动、语义、物理代理、安全行为 | 算法名称本身带来通用能力;训练 reward 可兼任终评 |
| 蒸馏 / consistency / DMD | student 或采样映射 | 更少 NFE、低延迟;与 reward 合训时也可改变偏好 | 更快就等于更强、更安全或更多样 |
| test-time search / guidance / adaptation | 候选、latent 或临时参数 | 当次请求的条件满足、个性化或约束 | 冻结 base checkpoint 永久获得该能力 |
| 外部规划器 / VLM / verifier | 完整系统 | 分解、检查、重试、自我修正和闭环 | 能力可归因给单个视频生成权重 |
VideoDPO 用多维偏好构造视频生成的 DPO 训练 [13];VideoAlign 同时比较训练期 Flow-DPO / Flow-RWR 和推理期 Flow-NRG,说明“更新权重”和“当次引导”必须分开 [14];T2V-Turbo 把 reward 与 consistency distillation 组合,承担“偏好改善”和“少步生成”两份不同规格 [15]。完整方法、成本与 reward-hacking 审计见视频后训练与对齐。
4.1 真正可以称为能力的是“可适配性”
若研究问题是“这个 base model 是否适合作为 foundation model”,可以把可适配性 / 可对齐性作为元能力,但要用结果定义,而不是用“支持 LoRA”或“做过 SFT”定义。最低报告包括:
- 固定 base checkpoint、数据与预算,比较全参、adapter / LoRA 和冻结 backbone;
- 报告单位数据、更新参数和训练 FLOPs 带来的 C1–C9 分项增益;
- 测试未见任务、未见域和不同条件接口的迁移;
- 同时报告旧能力遗忘、模式收缩、reward hacking、安全和多样性回退;
- 将 adapter、post-trained checkpoint 与 base checkpoint 分别命名和归档。
5. 模型与系统的能力归因
| 观察到的结果 | 正确归属 | 需要的对照 |
|---|---|---|
| base checkpoint 在冻结设置下稳定通过测试 | base 能力 | 固定 tokenizer、scheduler、seed、NFE 与条件编码器 |
| 物理 reward 后专项分数提高 | post-trained checkpoint 的 C7 行为改善 | 同 base、独立 evaluator、反事实与多样性测试 |
| VLM 生成计划、挑选候选并重试后成功 | 编排系统的 C8 / C9 能力 | 去掉 planner、judge、搜索预算的模块消融 |
| upscaler 把结果提升到 4K | 最终 pipeline 的输出规格 | 同时报 base 输出与后处理输出 |
| 服务端过滤有害请求并添加来源声明 | 服务的安全与治理属性 | 固定政策、阈值、版本、误杀/漏检与去除攻击 |
安全、鲁棒性、校准、多样性和跨域泛化应横向检查 C1–C9;延迟、显存、吞吐、能耗、流式和 provenance 则应作为系统属性单列。它们都很重要,但不宜与“物理一致性”并列成同一种认知能力。
6. 能力分类的使用方法
| 你要回答的问题 | 入口 |
|---|---|
| 模型会什么,各能力边界在哪里? | 本页:基础模型能力地图 |
| 一个视频基础模型系统怎样从数据走到服务? | 视频基础模型系统及归因表 |
| 一个任务允许什么输入、必须保持什么? | 任务—能力矩阵 |
| 模型内部用什么表示、目标、骨干和部署机制? | 生成模型路线 |
| 后训练到底更新谁、花费什么、改善什么? | 后训练—目标能力矩阵 |
| 一项能力声明需要什么指标和证据? | 能力—评测矩阵 |
| 物理、推理和动作闭环怎样逐级验证? | 物理一致性 · Video Reasoning · World Model |
建议每篇模型或产品报告都附一张最小 claim card:
7. 能力限制与研究问题
- C3 长时状态:生成长度增长很快,但离场再现、不可逆状态和多镜头记忆仍缺稳定协议。
- C7 因果物理:可见违规 benchmark 增多,单因素干预、参数响应与 OOD 材料仍不足。
- C8 生成式推理:需要把答案、可见过程、内部去噪机制和外部搜索预算分开。
- C9 决策效用:动作响应演示不能替代策略排序、闭环收益和独立环境验证。
- 元能力可适配性:需要统一的数据效率、更新参数、遗忘与跨能力干扰报告。
- 归因边界:产品越来越多地组合 prompt compiler、多个 checkpoint、音频、SR、judge 与安全模块;单模型能力更难从最终样例反推。
本页的检索范围、证据分级、纳排理由与图像检查记录见研究日志。
资料版本
手册结构修订:2026-09-20。原资料覆盖日期:2026-09-02。动态资源状态以条目日期和官方入口为准;未标注本仓库复现的实验数字均按其引用来源理解。
参考文献
[1] Bommasani et al. On the Opportunities and Risks of Foundation Models. arXiv preprint. 2021.
[2] Huang et al. VBench: Comprehensive Benchmark Suite for Video Generative Models. CVPR. 2024.
[3] Zheng et al. VBench-2.0: Advancing Video Generation Benchmark Suite for Intrinsic Faithfulness. arXiv preprint. 2025.
[4] Wei et al. UniVBench: Towards Unified Evaluation for Video Foundation Models. CVPR. 2026.
[5] Sun et al. T2V-CompBench: A Comprehensive Benchmark for Compositional Text-to-video Generation. CVPR. 2025.
[6] Yao et al. SV4D 2.0: Enhancing Spatio-Temporal Consistency in Multi-View Video Diffusion for High-Quality 4D Generation. ICCV. 2025.
[7] Hua et al. VABench: A Comprehensive Benchmark for Audio-Video Generation. CVPR. 2026.
[8] Meng et al. Towards World Simulator: Crafting Physical Commonsense-Based Benchmark for Video Generation. ICML. 2025.
[9] Bansal et al. VideoPhy-2: A Challenging Action-Centric Physical Commonsense Evaluation in Video Generation. ICLR. 2026.
[10] Li et al. WorldModelBench: Judging Video Generation Models As World Models. NeurIPS Datasets and Benchmarks. 2025.
[11] Wiedemer et al. Video models are zero-shot learners and reasoners. arXiv preprint. 2025.
[12] Assran et al. V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning. arXiv preprint. 2025.
[13] Liu et al. VideoDPO: Omni-Preference Alignment for Video Diffusion Generation. CVPR. 2025.
[14] Wu et al. Improving Video Generation with Human Feedback. NeurIPS. 2025.
[15] Li et al. T2V-Turbo: Breaking the Quality Bottleneck of Video Consistency Model with Mixed Reward Feedback. NeurIPS. 2024.