世界模型与基于模型的决策
介绍潜在状态、随机动力学、动作条件预测和规划的主要方法。
前置知识: 状态空间模型、强化学习基础。
使用步骤: 选择观测、状态、动作和奖励表示 → 训练预测器并接入规划或策略 → 检查长期误差、策略利用模型误差和现实迁移。
本章讨论的不是“哪一个视频模型看起来最像世界”,而是一个更严格的问题:模型能否在动作干预下维护状态、预测多种可能未来,并让真实环境中的决策变得更好? 资料检索与发布状态核验截止到 2026-08-30;检索式、纳排规则、证据等级和图稿记录见研究日志。
章节分工
本章负责状态表示、动力学与规划的共同基础。WAM负责预测与动作耦合;动作条件预测负责条件预测与时间规格;交互式世界生成负责持续观测流、回访与环境接口;Coding World Model负责程序化状态及视觉接口;详细报告集中于世界模型评测协议。
学习目标
读完本章,应当能够:
- 区分 video generator、predictive world model、world action model、controllable simulator、policy 与 environment model。
- 解释 deterministic latent dynamics、stochastic latent dynamics 和 RSSM 各自保留了什么信息。
- 从机制与用途理解 World Models、PlaNet、Dreamer、MuZero、TD-MPC、Genie、GameNGen 和机器人 WAM 的关系。
- 比较“planner/policy + video generator”级联路线与 joint action–video model 联合路线。
- 设计包含 action verifier、persistent state、反事实、不确定性和 receding-horizon feedback 的闭环。
- 用分层协议评价画质、状态/动作忠实度、决策效用和现实迁移,而不是只看一段 demo。
1. 基本概念
先固定符号。观测为 \(o_t\),不可直接观测的环境状态为 \(s_t\),动作或动作块为 \(a_t\),目标为 \(g\),内部记忆为 \(m_t\)。一个动作条件预测器近似:
这条式子仍不足以说明系统会规划、会执行或能在现实中安全工作。
| 概念 | 最小输入/输出 | 训练或使用目标 | 最低成立证据 | 不能自动推出 |
|---|---|---|---|---|
| Video generator | 文本/图像/视频条件 → 视频 | 生成视觉上合理的时空样本 | 视觉质量、运动质量、多样性 | 动作因果、可执行性、规划价值 |
| Predictive world model | 历史状态/观测 + 候选动作 → 未来状态、观测、奖励或价值 | 学习动作条件转移 | 动作分支、状态转移或 return 验证 | 一定生成像素;一定就是 policy |
| World action model (WAM) | 观测/目标 → 动作,并在推理时与未来预测耦合 | 让“想象未来”和“产生动作”共同服务控制 | 未来预测与动作生成在同一推理闭环中发生 | 任意任务零样本成功;因果模型已识别 |
| Controllable simulator | 外部动作/事件 → 可持续交互的观测流 | 作为人或 agent 可操控的环境 | 动作响应、实时性、长时状态与回访一致性 | 能输出真实设备可执行动作 |
| Policy | 状态/观测/目标 → 动作分布 | 最大化真实或仿真环境中的任务收益 | 外部环境成功率、return、风险 | 拥有显式或可视化世界模型 |
| Environment model | 状态 + 动作 → 下一状态/奖励/终止 | 复现某一环境的转移接口 | 对该环境的转移与 reward fidelity | 是大规模预训练模型;覆盖开放世界 |
机器人 WAM 教程把 WAM 定义为一种 policy:它的动作生成在推理时与未来预测耦合,并归纳出 imagine-then-execute、video-feature-conditioned action、joint video–action、auxiliary video prediction 四类范式 [1]。机器人 world-model 综述则从“为 policy 提供预测”“作为 simulator”“robotic video world model”组织系统 [2]。两种分类并不冲突:前者问动作如何产生,后者问世界模型在整个学习系统中扮演什么角色。
三个判断边界尤其重要:
- 视频先验不是干预模型。 从自然视频学到“通常接下来发生什么”,不等于学到“如果我换一个动作会发生什么”。
- 联合输出不是因果证明。 同一 backbone 同时生成视频与动作,可以改善表示对齐,却仍可能复现数据中的相关性。
- 交互 demo 不是决策效用。 键鼠能改变画面只证明接口存在;规划价值要在独立环境或真实机器人中验证。
2. 状态与动力学
2.1 Deterministic latent dynamics
最简单的 latent world model 用一个确定性状态递推:
优点是 rollout 快、缓存简单、同一动作序列可复现;缺点是把所有不确定性压进单一路径。当门后是否有人、遮挡物如何运动或接触结果本来就有多种可能时,均方误差会产生模糊平均,离散 token 则可能过早锁定一个未来。
2.2 Stochastic latent dynamics
随机状态显式表示“一段历史之后仍不能确定”的部分:
模型可以采样多个 future rollouts,估计任务收益分布和失败概率。但“样本不同”不必然等于“概率校准”:若训练数据没有覆盖某类动作或接触,模型可能对错误未来非常自信。
2.3 RSSM:记忆与随机性的组合
PlaNet 的 recurrent state-space model(RSSM)把 deterministic recurrent state \(h_t\) 与 stochastic state \(z_t\) 组合 [5]:
这里的 posterior 在新观测到来时校正 belief,prior 在没有新观测时按动作想象;数学上与随机未来模型共享 variational state-space 接口。ELBO、prior–posterior gap、posterior collapse、aleatoric/epistemic 分账见变分随机视频生成;reward/continue、planner、return 与 model exploitation 仍由本章负责。两种验收不能互相替代。
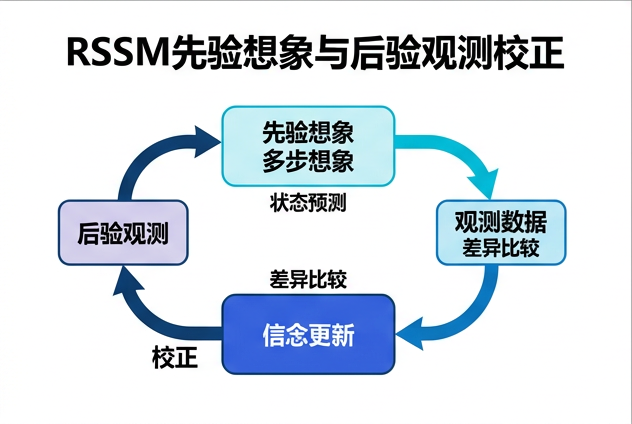 图 1:RSSM 的“先验想象—后验校正”结构。实线表示有观测时的更新,虚线表示仅依靠 learned dynamics 的 rollout。
顺序化文字替代:
- 上一时刻的确定性状态、随机状态和动作进入 recurrent transition。
- transition 产生新的确定性记忆 \(h_t\)。
- 没有新观测时,从 prior 采样 \(z_t\) 并继续想象;有新观测时,encoder 与 \(h_t\) 共同形成 posterior。
- \(h_t,z_t\) 用于重建观测或预测 reward/value;真实观测到达后,posterior 把 rollout 重新锚定到环境。
2.4 同是 model-based,预测目标并不相同
| 路线 | 模型预测什么 | 决策怎样使用模型 | 主要优势 | 主要风险 |
|---|---|---|---|---|
| World Models [4] | 图像 latent 的 recurrent dynamics | controller 在 learned environment 中训练 | 建立“表示—世界—策略”分工 | learned environment 可被 controller 利用 |
| PlaNet / RSSM [5] | latent state 与 reward | 在线搜索候选动作序列 | 从像素直接做 latent planning | horizon 越长,模型误差越容易累积 |
| Dreamer [6] | latent trajectory、reward、continuation | imagined actor–critic | 避免每一步昂贵的在线搜索 | actor 会偏好模型的乐观区域 |
| MuZero [7] | reward、value、policy 所需的任务相关状态 | tree search | 不要求重建完整观测 | latent 对决策充分,不等于可视世界完整 |
| DreamerV3 [8] | 统一 RSSM 下的多域 dynamics | imagined policy learning | 一套配置跨广泛任务 | 算法通用不等于共享世界知识的单 checkpoint |
| TD-MPC2 [9] | task-oriented latent、reward、value | trajectory optimization + learned policy prior | 多任务连续控制、滚动规划高效 | 仍依赖训练任务覆盖和短时可靠 rollout |
因此,world model 没有唯一正确的输出空间。若用途是控制,只需保留 reward-relevant state;若用途是人可检查的交互环境,就还要生成视觉与声音;若用途是训练通用机器人,动作、接触、对象状态和语言目标都可能是必要变量。
2.5 可执行程序状态
状态也可以存储为实体表、事件和规则,由程序执行转移,而非全部编码在神经 latent 中。程序可被学习、检验和修正;视频模型则可以充当条件观测生成器。这一混合结构的机制、代表方法和评测见 Coding World Model。它扩展本章的表示选择,不取代随机状态、观测校正和规划验证。
3. 主要技术路线
3.1 动作条件预测:先回答“做了之后会怎样”
Action-Conditional Video Prediction 在 Atari 中把动作显式放进未来帧预测 [3]。World Models、PlaNet、Dreamer 和 MuZero 随后把 latent prediction 接到 controller、planning 或 value search。这个时期的实验域小,却建立了最严格的验收方式:最终要看外部环境 return,而不只是下一帧误差。
2023 年后出现两种规模化:
- DreamerV3 和 TD-MPC2 扩大算法、任务与 embodiment 覆盖,但核心仍是决策型 latent model。
- GAIA-1 和 UniSim 把生成视频先验接到驾驶或机器人动作,开始形成可供策略训练或评估的视觉模拟器 [10] [11]。
3.2 无动作视频:先学世界,再识别 latent action
Genie 从无动作标签的平台游戏视频中学习 video tokenizer、latent action model 与 autoregressive dynamics,并在生成时用 latent action 控制下一帧 [12]。它解决的是“互联网视频没有控制标签时,怎样发现可控变化”,但 latent action 不天然对应现实机器人的关节、末端位姿或力。
ViPRA 延续这条思路:预训练时联合预测未来视觉与 motion-centric latent action,再用较小的 flow decoder 映射为连续动作块 [21]。这种设计把 action-free video 的规模优势带入 policy,但动作落地仍依赖少量带动作数据及 embodiment-specific decoder。
3.3 神经交互环境:把下一帧生成推到实时闭环
| 系统 | 机制与用途 | 作者报告的系统尺度 | 证据边界 |
|---|---|---|---|
| GameNGen [13] | action-conditioned diffusion 自回归生成 Doom;用上下文噪声增强训练缓解误差累积 | 单 TPU 超过 20 FPS | 单一游戏;实时画面不等于通用状态正确 |
| DIAMOND [14] | diffusion world model 作为强化学习环境;同时报告 Atari 与 CS:GO | CS:GO 约 10 FPS(RTX 3090);开源代码与可玩 demo | learned model 中“多跳”错误会被 agent 利用,正是 model exploitation |
| Oasis [15] | Minecraft 风格 action-conditioned video world model;dynamic noising 稳定长 rollout | 项目页报告约 20 FPS | 开放 500M 权重与更大在线 demo 不是同一证据面 |
| Genie 2 / Genie 3 [32] [33] | 从提示生成可键鼠控制的世界,官方展示长时一致性与 promptable events | 以机构发布和交互 demo 为主 | 没有同等级公开论文、权重与独立闭环评测,不能按 checkpoint 证据表述 |
GameNGen、DIAMOND 和 Oasis 的意义不只是“会玩游戏”。它们把 action rate、渲染 FPS、闭环延迟、自由 rollout 稳定性 暴露为系统变量,也清楚展示了策略可能主动寻找 learned simulator 的漏洞。
开放域 video generator 是另一条重要支流:Sora 技术报告把大规模视频生成表述为 world-simulator 研究方向,但没有公开动作接口或规划实验 [16];Cosmos 把 tokenizer、生成模型、数据处理和后训练组织为 Physical AI 平台,却也不能让每个 checkpoint 自动获得闭环控制能力 [31]。它们提供 world prior 与工程底座,不应仅凭命名升级为 WAM。
4. 预测与动作生成
预测在推理时怎样参与动作产生或选择、四种耦合范式及其验收,集中见 WAM:预测与动作生成。本章继续负责状态与动力学、搜索与校正的共同基础。
5. 级联与联合建模
架构图、在线 imagine–evaluate–act 与离线 imagine–label–train、WAV、ViPRA、DreamZero 及设计取舍,见 WAM:级联与联合架构。该专题保留相关原文、公式、实验条件和引用。
6. 规划系统组成
6.1 Action verifier:检查“状态像真”与“动作可达”
一个实用 verifier 至少要区分:
- state plausibility:候选下一状态是否符合物体、几何、接触和任务约束;
- action reachability:给定当前状态与候选下一状态,是否存在当前 embodiment 能执行的动作;
- trajectory consistency:逐步都合理的局部转移,组合后是否仍满足全局约束;
- epistemic warning:候选是否落在训练分布外,verifier 本身是否也不可靠。
只做美学或语义相似度评分,会偏爱“像成功”的视频,却可能放过穿透、瞬移、错误抓取或控制延迟。
6.2 Counterfactual intervention:固定初态,只换动作
动作条件模型必须通过配对干预测试。给定同一初态与随机种子,比较 no-op、左移、右移、抓取、释放等动作:
并检查三类变量:
- 应变变量:被动作直接影响的位置、接触、速度或对象状态应正确改变;
- 不应变变量:背景身份、未触碰物体、场景布局不应无故改变;
- 分支覆盖:随机未来应覆盖真实可达模式,而不是用纹理差异冒充因果多样性。
如果只有每条视频各自的 FVD/人评,而没有成对动作干预,就不能声称 action fidelity。
6.3 Uncertainty 与 model exploitation
风险不是模型偶尔犯错,而是 planner 会主动寻找模型最乐观的错误区域。DIAMOND 中 agent 可利用错误的多次跳跃规则,就是一个清楚例子 [14]。可采用:
- ensemble disagreement 或多 seed rollout;
- reward/value 与 dynamics 分开校准;
- conservative objective:任务价值减去 uncertainty 与 verifier penalty;
- OOD detector、action constraint 和真实环境 safety shield;
- 短 horizon、多次重规划;
- 在真实环境中记录“预测好、执行坏”的 exploitation cases,并回灌训练集。
不确定性也要分解:aleatoric uncertainty 表示世界本身有多未来,epistemic uncertainty 表示模型没有见过。前者适合风险分布,后者应触发保守动作、请求观测或停止。
6.4 Receding horizon:每次只相信一小段未来
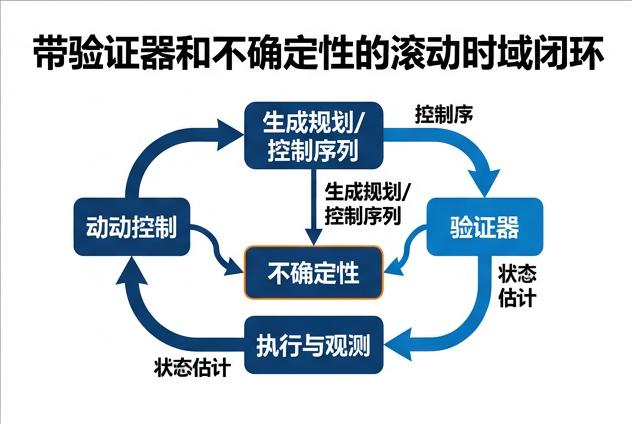 图 3:带 verifier、不确定性和 persistent state 的 receding-horizon 闭环。
顺序化文字替代:
- 系统从真实观测和 persistent state 产生 \(K\) 个候选动作及其未来。
- 价值模型、不确定性估计与 action verifier 共同评分。
- 系统只执行第一个动作或短 action chunk,而不盲目执行完整 imagined plan。
- 新观测到达后,模型做 posterior correction,更新实体、空间与事件状态。
- 如果预测误差超过阈值,系统进入减速、重新感知或安全策略;否则进入下一轮规划。
闭环总延迟为感知、候选生成、评分、控制通信和执行等待之和。渲染 20 FPS 不代表 20 Hz action rate,更不代表 50 ms 以内的 sense-to-act latency。
7. 长期状态
长期交互需要区分以下状态职责:
其中 \(\epsilon_{t+1}\) 是预测与真实观测的 innovation。可操作的 memory 需要“写入、覆盖、检索、遗忘和置信度”,而不只是缓存更多帧。
| 层 | 保存内容 | 典型实现 | 必须测试 |
|---|---|---|---|
| Recent context | 最近动作、速度、局部外观 | sliding window、KV cache | 短时运动连续性、延迟 |
| Entity state | 对象身份、属性、是否已移动/打开/损坏 | object slots、entity table | 遮挡后重现、状态不回滚 |
| Spatial memory | 位姿、地标、拓扑、可见区域 | pose/geometry-indexed bank | loop closure、回访一致性 |
| Event memory | 动作及其长期后果 | event graph、trajectory summary | 因果顺序、长期任务约束 |
| Uncertainty memory | 哪些状态来自观测、推断或低置信生成 | per-state confidence、age | 冲突更新、过期信息降权 |
7.1 2025–2026 的三种长时机制
压缩历史、无位姿层级记忆和固定 KV 加地标检索的机制、作者条件与发布边界,集中见交互式世界生成的记忆案例。本章保留上述通用状态职责及下面的 probe 定义。
7.2 长时评测不能只报“生成了多少秒”
至少构造四类 probe:
- 回访:离开房间后返回,布局、已移动物体与已打开门是否保持;
- 离屏演化:对象在视野外仍按动力学运动,重新出现时状态是否正确;
- 事件持久:执行“取走—放置—绕行—返回”,任务状态是否不回滚;
- 冲突更新:新观测否定旧记忆时,系统是否覆盖旧状态并降低过期缓存权重。
报告首次不可恢复错误的时间、loop-closure error、entity identity switches 和 event-state accuracy,比只报最长样片更有诊断力。
8. 系统与能力报告
详细的 WM0–WM6 字段、与 L0–L7 的映射、感知/状态/反事实/决策指标、WorldEval/WorldGym/MiraBench/RoboWM-Bench 比较及最小报告矩阵,集中见世界模型报告与评测协议。报告应分别注明来源、系统运行条件和被实验支持的能力。
9. 代表方法
| 工作 | 在本章中的角色 | Paper | Project / code | 来源与发布内容(2026-08-30 快照) |
|---|---|---|---|---|
| WAM concise tutorial [1] | 定义与四范式 | arXiv v7 | 作者论文页 | 预印本入口:最新教程,非基准结论 |
| World Model for Robot Learning survey [2] | policy-centric taxonomy | arXiv | 论文入口 | 预印本入口:最新综述,非原始实验 |
| DreamGen [19] | 级联式离线合成数据 | CoRL 2025 / PMLR | Project · Code  |
正式入口:正式论文 + 四阶段代码 |
| World Action Verifier [20] | state plausibility + action reachability | arXiv v2 | Project · Code  |
预印本入口:论文 + 代码;workshop 荣誉,不是主会 |
| ViPRA [21] | latent action 与 future feature 联合预训练 | ICLR 2026 OpenReview | Project · Code  |
正式入口:官方会议记录 + code/weights |
| LPWM | object-particle + latent-action 的相邻变分桥接支线 | ICLR 2026 Oral | Project · Code  |
正式入口:正式会议记录 + code/data/weights;对象化场景与相机运动仍是边界 |
| DreamZero [22] | joint video–action 闭环 policy | arXiv | Project · Code  |
预印本入口:论文 + 项目 + 代码 |
| WorldPack [23] | 动态帧压缩与几何检索 | arXiv v3 | 论文入口 | 预印本入口:论文;开放面需逐项核对 |
| Infinite-World [24] | pose-free hierarchical memory | arXiv v2 | Project | 论文/展示:论文 + demo;未见等价完整代码 |
| ReWorld—long-horizon memory [25] | 固定 KV + landmark bank | arXiv v1 | Code  |
部分发布:inference code,weights 未发布 |
| ReWorld—reward modeling [26] | 多维 embodied reward | arXiv | 论文入口 | 预印本入口:同名不同工作 |
此列只记录来源与发布内容,不赋予能力等级。正式发表入口、预印本、机构展示和 artifact 可得性分别理解;能力结论由相应 L0–L7 实验支持。旧记录中的 A/B/C/D 分别指正式入口与 artifact、预印本与作者入口、机构展示、二手线索,保留这一解释供历史记录对照。
10. 使用限制
如果出现下列情况,应停止扩大能力声明:
- 只有 cherry-picked demo:只能写“展示了样例”,不能写“长期一致”。
- 只有生成器中的 planner 分数:不能写“改善真实决策”。
- 只给 FPS:不能写“实时闭环”,除非 action rate 与 p95 latency 也达标。
- 只给平均画质:不能写“动作忠实”,除非有 paired counterfactual。
- 只发布项目页:不能写“开源”,除非 code、weights、license 与可运行入口明确。
- 同名或改名论文未消歧:必须带完整副标题、版本或 arXiv ID。
- policy 和 world model 共用数据/评分器:必须报告泄漏检查与独立真值环境。
- 模型产生不确定候选但系统仍整段执行:不能称风险感知闭环。
一个可接受的能力表述模板是:
在【指定数据、任务、动作空间和硬件】下,该系统以【级联/联合】方式把未来预测用于【数据生成/规划/动作输出】,通过【WM2–WM6 中的具体证据】支持【有限结论】;其【长期状态、反事实、OOD、不确定性或现实迁移】仍未被相应实验验证。能力结论另按全局 L0–L7 标注。
11. 延伸阅读
- 从 World Models、PlaNet、Dreamer、MuZero 理解“完整像素”与“对决策充分”的区别。
- 从 TD-MPC2、DINO-WM、V-JEPA 2 理解 latent planning 与 receding horizon。
- 从 Genie、GameNGen、DIAMOND、Oasis 理解 latent action、实时交互与 model exploitation。
- 到 WAM 从 DreamGen、WAV、ViPRA、DreamZero 比较级联和联合架构。
- 到交互世界的记忆案例从 WorldPack、Infinite-World、两篇 ReWorld 理解 compression、persistent state 与 reward/verifier 的不同职责。
- 最后用世界模型协议的 WM0–WM6 字段审查每个新发布,再映射到全局 L0–L7;不要把产品 demo、paper 和 checkpoint 混为一种证据。
相邻章节:动作条件预测、交互式世界生成、循环预测、JEPA、物理一致性与评测指南。
资料版本
结构调整:2026-10-15。架构、记忆案例和详细报告已按章节职责整理;本章及迁入页面保留原技术内容与 2026-08-30 来源快照。本次未刷新模型发布状态或开展模型复现。
参考文献
[1] From World Models to World Action Models: A Concise Tutorial for Robotics. arXiv:2607.00836, v7. 2026.
[2] World Model for Robot Learning: A Comprehensive Survey. arXiv:2605.00080. 2026.
[3] Action-Conditional Video Prediction using Deep Networks in Atari Games. NeurIPS. 2015.
[4] World Models. arXiv:1803.10122. 2018.
[5] Learning Latent Dynamics for Planning from Pixels. ICML / PMLR 97. 2019.
[6] Dream to Control: Learning Behaviors by Latent Imagination. ICLR. 2020.
[7] Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model. Nature. 2020.
[8] Mastering Diverse Control Tasks through World Models. Nature 640:647–653. First public as arXiv:2301.04104 in 2023; formally published in 2025.
[9] TD-MPC2: Scalable, Robust World Models for Continuous Control. ICLR. 2024.
[10] GAIA-1: A Generative World Model for Autonomous Driving. arXiv:2309.17080. 2023.
[11] Learning Interactive Real-World Simulators. ICLR. 2024.
[12] Genie: Generative Interactive Environments. ICML / PMLR 235. 2024.
[13] Diffusion Models Are Real-Time Game Engines. ICLR. 2025.
[14] Diffusion for World Modeling: Visual Details Matter in Atari. NeurIPS. 2024.
[15] Oasis: A Universe in a Transformer. Decart and Etched, official project and artifacts. 2024.
[16] Video Generation Models as World Simulators. OpenAI technical report. 2024.
[17] DINO-WM: World Models on Pre-trained Visual Features Enable Zero-shot Planning. arXiv:2411.04983. 2024.
[18] V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning. arXiv:2506.09985. 2025.
[19] DreamGen: Unlocking Generalization in Robot Learning through Video World Models. CoRL / PMLR 305. 2025.
[20] World Action Verifier: Self-Improving World Models via Forward-Inverse Asymmetry. arXiv:2604.01985, v2. 2026.
[21] ViPRA: Video Prediction for Robot Actions. ICLR. 2026.
[22] World Action Models are Zero-shot Policies. arXiv:2602.15922. 2026.
[23] WorldPack: Dynamic Frame Compression for Long-context Video World Modeling. arXiv:2512.02473, v3. 2026.
[24] Infinite-World: Scaling Interactive World Models to 1000-Frame Horizons via Pose-Free Hierarchical Memory. arXiv:2602.02393, v2. 2026.
[25] ReWorld: An Interactive World Model with Long-Horizon Memory. arXiv:2608.23565. 2026.
[26] ReWorld: Multi-Dimensional Reward Modeling for Embodied World Models. arXiv:2601.12428. 2026.
[27] WorldEval: World Model as Real-World Robot Policies Evaluator. arXiv:2505.19017. 2025.
[28] WorldGym: World Model as An Environment for Policy Evaluation. arXiv:2506.00613, v3. 2025.
[29] MiraBench: Evaluating Action-Conditioned Reliability in Robotic World Models. arXiv:2605.29360. 2026.
[30] RoboWM-Bench: A Benchmark for Evaluating World Models in Robotic Manipulation. arXiv:2604.19092, v2. 2026.
[31] Cosmos World Foundation Model Platform for Physical AI. arXiv:2501.03575. 2025.
[32] Genie 2: A Large-Scale Foundation World Model. Google DeepMind official research release. 2024.
[33] Genie 3: A New Frontier for World Models. Google DeepMind official research release. 2025.