视频预测
介绍根据历史观测建模未来视频的确定性、随机性与滚动预测方法。
前置知识: 条件概率、时序模型。
使用步骤: 划分可见历史与预测区间 → 区分训练目标和推理输入 → 评估多步误差、未来覆盖及校准。
检索式、结果数、纳排规则、逐篇标题/ID/venue 核验、FramePack 版本史、图片生成记录和验收命令见配套研究记录。
学习目标
读完本章,应能完成六件事:
- 用“测试时可见什么”和“输出是什么”区分预测、插值、条件生成、latent prediction 与 world model;
- 写出逐帧、分块、一次性和随机 rollout 的完整 tensor contract,并发现未来帧泄漏;
- 把 deterministic pixel/transform、stochastic latent、diffusion/score、latent/token/foundation continuation 与 decision-aware prediction 放进同一坐标系;
- 解释 teacher forcing、scheduled sampling、self forcing 与 Diffusion Forcing 解决的是不同问题;
- 按单步保真、多步开环、分布校准、OOD/干预、闭环效用五级组织证据;
- 对任何“长视频世界模型”主张提出可复现的里程碑验收,而不是接受精选样例。
1. 任务定义
设 RGB 观测前缀和未来目标分别为
确定性预测器输出一个点估计
随机预测器则学习条件分布 \(p_\theta(Y\mid X)\),测试时应报告 \(K\) 个独立或有设计的样本 \(\lbrace\hat Y^{(k)}\rbrace_{k=1}^{K}\)。严格限制针对的是部署推理:真实未来 \(Y\) 或其编码不得作为部署路径的模型输入。训练期可以把 \(Y\) 用于损失目标、扩散加噪/腐蚀输入、变分 posterior、teacher forcing,或构造 stop-gradient foresight teacher/target,但这些都必须标为 train-only 并在部署时移除。离线评价可以用 \(Y\) 比较预测,也不得回流到当次推理。
“预测一帧”和“预测一块”还需显式写出块长 \(b\):
\(U\) 可以把生成帧追加到滑动窗口、更新递归状态,或把历史压缩进固定预算的 memory。若训练时 \(U\) 接收真实帧、测试时却接收生成帧,就存在 forcing gap;若论文没有写清 \(b\)、窗口长度、状态是否重置和采样随机性,所谓“长 rollout”不可复现。
1.1 六个相邻概念的边界
| 名称 | 测试时条件 | 输出 | 何时属于本章 | 最常见的越界表述 |
|---|---|---|---|---|
| Video prediction | 仅过去观测;可另有已声明外生变量 | 未来像素或对应未来状态 | 目标时间严格晚于最后一帧条件 | 把测试未来帧的 feature 当成“辅助条件” |
| Video frame interpolation(VFI) | 查询时刻两侧都有真实端点 | 端点之间的帧 | 不属于;它是双侧条件重建 | 用插值结果证明外推能力 |
| Future frame synthesis | 术语本身不限定条件 | 一个或多个“未来”画面 | 只有 past-only 时才与 prediction 同义 | 文本、终点图、pose 或完整轨迹也输入,却仍叫无条件预测 |
| Action-conditioned prediction | 过去观测加未来动作 \(a_{T_c:T_c+T_h-1}\) | 动作条件下的未来 | 是预测的条件化子类,规格为 \(p(Y\mid X,A)\) | 与被动 \(p(Y\mid X)\) 混算;把相关性当干预效应 |
| World model | 状态/观测、动作,常含 reward/termination | 可用于决策的状态转移或观测 | 只有预测进入 planning/control 并验证 utility 时 | 一段逼真视频直接升级成“可规划世界模型” |
| Latent state prediction | 过去像素或 latent | 未来 \(z\)、token、trajectory | \(z_t\) 与未来观测/任务目标有明确定义 | 没有 decoder 或 probe 仍声称像素正确 |
| Generative continuation | 图像/视频前缀,可叠加文本等 | 视觉上合理的后续 | 只在条件规格与真实未来分布匹配时 | 把 prompt adherence、审美或任意续写当预测准确性 |
一个随机预测器当然会“生成续写”,但生成续写并不自动是预测证据。前者可追求条件下的可看性;后者必须说明数据生成过程、时间因果方向,以及采样分布是否覆盖真实可能未来。
若提供未来动作,规格变为
这允许比较不同动作的反事实后果,但仍不保证因果可识别:行为策略覆盖不足、动作与隐藏状态混杂、观测缺失,都可能让模型只记住数据相关性。PlaNet 把 stochastic/deterministic latent dynamics 接到 online planning,是“预测如何成为决策模型”的早期正式范例;它不是被动视频预测 benchmark 的同义词 [9]。
flowchart LR
    H[历史帧与条件] --> P[未来预测器]
    P --> S[多个候选未来]
    S --> R[使用预测结果继续滚动]
    R --> P
    S --> E[离线评测]
    T[真实未来:仅供离线评测] --> E
    E --> V[VP0 短期保真 / VP1 多步稳定]
    E --> D[VP2 分布与校准 / VP3 干预与泛化]
    E --> C[VP4 独立闭环效用]
图注: 图示为部署预测与离线评测流程。VP0–VP4 是本章的测试项目编号,与全手册 L0–L7 报告约定分开。真实未来不能作为部署输入;训练期允许使用的后验、教师和目标分支在后文另行说明。
图的顺序化文字替代:
- 观测前缀是推理时唯一的真实视频输入。
- 模型预测下一帧或下一块,并把自己的生成结果用于下一次预测。
- 随机模型从同一前缀产生 \(K\) 个可能未来,再交给评估器。
- 真实未来在这张“部署推理 + 离线评价”图中只进入 loss/metric,不能回到当次部署推理;训练期可有另外的 train-only 未来监督路径。
- 证据依次从 VP0 单步保真、VP1 多步开环、VP2 分布与校准、VP3 OOD 与干预,上升到 VP4 闭环效用。
2. 训练与滚动预测接口
flowchart TB
    X[历史帧 X] --> Train[训练期预测]
    Y[真实未来 Y] --> Aux[后验、加噪或监督目标]
    Aux --> Train
    Train --> Loss[训练损失与参数更新]
    X --> Infer[部署期预测器]
    Seed[随机种子与已知条件] --> Infer
    Infer --> Future[预测未来]
    Future --> History[更新生成历史]
    History --> Infer
训练图概括允许的未来监督路径,具体分支取决于模型。部署路径只读取历史、合法条件与随机变量。 顺序化文字替代:
- 把完整训练片段沿时间切成 \(X\) 与 \(Y\),并保留原始时间戳/FPS。
- 在 train-only 分支中,\(Y\) 可进入加噪/腐蚀、posterior、teacher forcing、foresight teacher/target 或损失;它们只用来学习参数。
- 部署时删除整个 train-only 分支,只把 \(X\)、随机种子和已生成状态交给 predictor,输出长度为 \(b\) 的帧块。
- 把预测块追加、递归更新或压缩进上下文,再预测下一块。
- 重复到 \(T_h\),得到形状为 \(K\times B\times T_h\times3\times H\times W\) 的样本集;离线评价再与 \(Y\) 比较,不回流到该次 rollout。
2.1 四种实现规格
| 规格 | 训练输出 | 推理状态 | 关键复现字段 | 典型风险 |
|---|---|---|---|---|
| Direct / one-shot | 一次输出全部 \(T_h\) 帧 | 无自回灌 | \(T_h\) 是否固定、时间位置编码 | 训练视野之外无法自然延长 |
| Frame autoregression | 下一帧 \(b=1\) | 生成帧或 recurrent state | warm-up、窗口、状态 reset、sampling | 误差逐帧复合,吞吐低 |
| Block autoregression | 下一块 \(b\gt1\) | 生成块与压缩历史 | 块重叠、边界融合、block FPS | 块内一致但块间跳变 |
| Latent/token rollout | \(z\) 或离散/连续 token | latent KV cache 或 state | encoder 是否冻结、decoder、token 顺序 | latent 好但像素/物理不可读 |
Latent 规格至少应写成
如果 \(E\) 在训练中同时看见未来或是非因果序列编码器,必须说明未来信息只构造 stop-gradient target,还是进入了 predictor 的输入。Video-Mirai 的做法属于训练期 foresight distillation:冻结的非因果 encoder 读取完整 rollout 构造目标,但部署 predictor 仍只看因果历史;这是一种训练监督,不是测试时预知未来 [24]。
2.2 forcing 不是一个开关
| 名称 | 当前预测所见历史 | 主要目标 | 不能自动保证什么 |
|---|---|---|---|
| Teacher forcing | 真实历史帧/token | 稳定的单步最大似然或重建训练 | 自回灌时的状态分布一致 |
| Scheduled sampling | 按课程混合真实与生成历史 | 缩小 train–test 输入差异 [7] | 一致概率估计、无偏梯度或长期稳定 |
| Self forcing | 训练也条件于模型自己生成的输出 | 直接优化 rollout 分布 | 所有架构都能低成本训练 |
| Diffusion Forcing | 每个 token 可处于不同噪声等级 | 用统一扩散目标训练因果序列模型 [15] | 与 scheduled/self forcing 完全等价 |
| Causal distillation | 因果 student 学双向/多步 teacher | 减少每帧去噪步数、支持流式生成 | student 已学到真实可干预动力学 |
Self Forcing 用自回归 rollout、KV cache、少步 diffusion 和 stochastic gradient truncation 训练 video-level objective,正式发表于 NeurIPS 2025 [19]。Diffusion Forcing 则给序列中每个 token 独立噪声等级,使过去不必全部加噪、未来可以逐个或分块生成;它优化的是扩散式序列目标,不能只因为名字相似就写成“scheduled sampling 的扩散版” [15]。
3. 建模方法
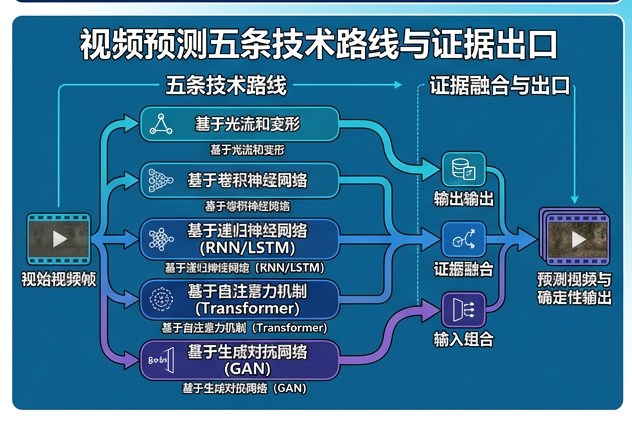 顺序化文字替代:
- 所有路线都从只含过去的前缀开始。
- 确定性像素/变换方法输出一个未来;随机 latent 与 diffusion 输出一个条件分布。
- latent/token 路线若解码到像素,就接受像素与分布评价;若不解码,只能接受 representation probe。
- decision-aware 路线把预测状态接入规划或控制,接受 success、return、regret 和安全评价。
- 多条路线可以组合;例如 latent diffusion 既属于 latent 表示,也属于 score-based 随机建模。
3.1 Deterministic pixel 与 transform:先验强、基线仍然重要
ConvLSTM 把二维卷积写进 LSTM 的输入到状态、状态到状态转移,在降水 nowcasting 上展示了空间递归预测 [1]。它奠定的是 tensor 归纳偏置,不是“通用世界模型”。PredNet 用分层 predictive coding 预测下一帧并研究无监督表征 [4]。SimVP 则用纯 CNN encoder–translator–decoder 和 MSE 在统一协议中取得强结果,提醒我们:复杂 recurrent/attention 结构若没有严格同分辨率、同 horizon、同训练预算对照,不能凭新颖性宣称进步 [12]。
逐像素 L1/L2 在多未来场景会把互斥运动平均成模糊图。Beyond MSE 组合多尺度、gradient-difference 与 adversarial loss,使预测更锐利;原论文结果不能被概括为“对抗损失解决了模糊和长期预测” [2]。锐利度提高也可能来自生成未被历史支持的纹理。
Transform 路线不直接从零画下一帧,而是预测如何搬运已观测像素。Finn 等人的 DNA/CDNA/STP 在机器人交互数据上学习 action-conditioned pixel motion:局部动态卷积核、多个变换加 mask,或空间变换参数 [3]。它们在物体延续和局部运动上有强先验,但对新显露区域、拓扑变化、光照与不可复制内容仍需生成分支。
3.2 Stochastic latent:把不可约多未来显式化
Deep Kalman Filters 先把变分推断与非线性 stochastic state transition 接到序列观测,提供了 latent state-space 的通用概率模板 [8]。SV2P 把随机 latent variable 加入多帧真实视频预测,同时研究 action-free 与 action-conditioned 设置 [5]。SVG 的 learned prior 进一步令每时刻 latent prior 依赖历史,并把 deterministic dynamics 与 stochastic residual 分开 [6]。一般目标可写成
训练 posterior 看见真实未来,部署 prior 看不见;二者错配、posterior collapse 与 best-of-\(K\) 挑样都会让“多样”看起来比实际分布校准更好。至少同时报告 sample-average、best-of-\(K\)、\(K\) 值、样本内/样本间多样性,以及覆盖与准确的权衡。
这条 direct stochastic-future 路线在 2019–2026 又分成 deep hierarchy、fully latent residual dynamics、clockwork/event temporal abstraction 与 object/module latent。categorical RSSM 是共享变分 state-space 数学、但以 action/reward/return 验收的相邻控制支线;LPWM 的 object-particle + latent-action ELBO 是二者的桥接点。严格纳入门、论文协议和 合成分叉方块数据示例 反证实验见变分随机视频生成。名字里只有 VAE/latent、但没有 future-aware posterior + 不看未来的 deployment prior + KL/ELBO 的系统,不应并入 direct 主线。
3.3 Diffusion / score:高保真条件分布与高昂 rollout
Video Diffusion Models 把 image diffusion 扩展到时空生成并包含 conditional video prediction,正式发表于 NeurIPS 2022 [13]。其标准噪声目标是
这里的 diffusion time \(\tau\) 与视频时间 \(t\) 不同。推理时每个未来帧/块需要多次去噪;长视频再乘以 autoregressive block 数,延迟与误差都会增长。
MCVD 是这条路线不可跳过的节点。 Masked Conditional Video Diffusion 独立掩掉整段过去条件或整段未来条件:只掩未来执行预测,只掩过去执行 backward prediction,两侧都掩执行无条件生成,两侧都保留执行插值。它以非递归 2D convolution 对帧块条件生成,再以 block-wise autoregression 延长视频,正式发表于 NeurIPS 2022 [14]。统一 mask 接口不等于四项任务难度相同,也不消除块间 drift;比较时必须锁定 condition length、prediction block、递归次数与采样预算。
CausVid 从慢的双向 diffusion teacher 蒸馏 few-step causal student,配合 distribution matching 与 ODE initialization,正式发表于 CVPR 2025 [17]。它证明高质量生成 backbone 可以被改造成更流式的自回归模型;但其速度和画质数字是特定硬件、分辨率、步数与数据协议的系统结果,不是任意预测任务的常数。
3.4 Latent、token 与 foundation continuation:压缩了输出,不免除规格
VideoGPT 将视频 VQ-VAE token 交给自回归 Transformer [10];NOVA 则不依赖量化码本,在时间上逐帧自回归、帧内按 set 双向建模,正式发表于 ICLR 2025 [16]。这类模型把高维像素分解为可扩展 token 顺序,但 token likelihood、prompt adherence 和主观画质都不能单独证明对一个真实未来分布的校准。
FramePack 更具体地处理固定 context budget。它按帧重要性压缩输入历史,使更多帧进入固定长度上下文,并以 endpoint、调整后的采样顺序和离散历史等设计抑制长程 drift;它可用于现有 next-frame/section video diffusion 的微调 [18]。边界必须写清:
- 首发:arXiv v1 于 2025-04-17 发布,题名为 Packing Input Frame Context in Next-Frame Prediction Models for Video Generation;
- 正式版本:最终题名为 Frame Context Packing and Drift Prevention in Next-Frame-Prediction Video Diffusion Models,作者表扩展,发表于 NeurIPS 2025;
- 功能:它是 context packing 加 drift-prevention sampling,不是物理预测、分布校准或闭环规划证据;
- 因果边界:某些 anti-drift 变体会先生成远端 section 再填中间段,因而不等于严格按时间顺序输出的在线 causal predictor。
2026 年的 Re2Pix 先预测冻结 foundation representation,再用 latent diffusion 渲染,并用 nested dropout 与 mixed supervision 缩小“真实 representation 训练、预测 representation 测试”的差距 [29]。这类 decomposition 很有希望,但 representation target、rendering target 和 rollout utility 必须分别验收。
3.5 Decision-aware prediction:从观测似然走向可行动状态
只预测对决策足够的状态可以避开不可控纹理。V-JEPA 2 先在大规模 action-free 视频上训练 joint-embedding predictor,再用小规模机器人轨迹后训练 V-JEPA 2-AC 并进行 planning [20]。因此“action-free V-JEPA 2 能理解视频”和“V-JEPA 2-AC 能按动作规划”是两层证据,不能合成一句“被动视频直接学会控制”。
决策规格至少包含
只有当 action intervention 会在 latent rollout 中产生正确、可区分的后果,并在真实环境提升 success/return 或降低 planning regret,才到达“world model utility”。
4. 代表方法
| 工作 | 输入 → 输出 | 训练与 forcing | Rollout | 它真正建立的证据 | 主要限制 |
|---|---|---|---|---|---|
| ConvLSTM, 2015 [1] | 雷达历史 → 未来图 | supervised sequence loss | recurrent state | 空间卷积递归适合网格时序 | 特定 nowcasting;点估计会平滑 |
| Beyond MSE, 2016 [2] | 历史帧 → 未来帧 | multiscale + GDL + adversarial | recurrent/direct 依设置 | 锐度需要超越纯 MSE | 锐利不等于分布正确 |
| DNA/CDNA/STP, 2016 [3] | 视频 + 动作 → 像素运动 | 真实机器人交互监督 | action-conditioned AR | 复制/warp 先验有利于物体运动 | 新显露内容和长程漂移 |
| SV2P, 2018 [5] | 历史,可选动作 → 随机未来 | latent-variable variational training | 多帧 recurrent | 真实视频多未来需要随机变量 | posterior/prior mismatch;评测依赖 \(K\) |
| SVG-LP, 2018 [6] | 历史 → per-step latent + future | learned prior 与 posterior | stochastic recurrent | history-dependent prior 分离确定/随机因素 | 长 rollout 仍积累状态误差 |
| PlaNet, 2019 [9] | 图像 + 动作 → latent/reward | latent dynamics learning | imagined planning | prediction 可按 task utility 验证 | 属于控制规格,不是纯视频画质榜 |
| VideoGPT, 2021 [10] | VQ video token → token | next-token likelihood | token AR | 离散 latent 支持生成与预测 | 量化损失、长 token 序列;仅 arXiv 来源 |
| FitVid, 2021 [11] | 历史,可选动作 → future | deterministic/stochastic ablation | recurrent | 简化架构仍可成强基线 | CoRR/arXiv;不应误写成正式 ICLR 接收 |
| SimVP, 2022 [12] | past tensor → future tensor | end-to-end MSE | one-shot | 纯 CNN 在固定协议下很强 | 单未来与短 horizon 不能覆盖不确定性 |
| Video Diffusion Models, 2022 [13] | noisy future + condition → future | diffusion score objective | conditional sampling | 扩散可统一生成与条件预测 | 多步采样昂贵 |
| MCVD, 2022 [14] | masked past/future blocks → missing block | condition dropout masks | block AR | 同一 score model 支持预测/回溯/插值/无条件 | 任务共享不等于无 drift 或公平协议 |
| Diffusion Forcing, 2024 [15] | token-wise noise states → sequence | 独立噪声等级的因果 diffusion | variable-length AR | 训练/采样/引导可在统一序列框架组合 | 不是通用长期正确性保证 |
| NOVA, 2025 [16] | continuous visual tokens → frame sets | temporal causal, spatial bidirectional | frame-by-frame AR | 无量化的 next-frame tokenization 可扩展 | foundation generation ≠ calibrated forecasting |
| CausVid, 2025 [17] | past/cache + noise → next block | bidirectional teacher → causal student | few-step causal AR | 双向 backbone 可蒸馏成流式 student | teacher/data/protocol 依赖强 |
| FramePack, 2025 [18] | packed frame context → next section | fine-tuning + sampling redesign | fixed-budget long context | 历史压缩与 anti-drift 可分开设计 | 部分采样次序非严格在线;无闭环证据 |
| Self Forcing, 2025 [19] | self-generated history → next video block | rollout training + truncated gradients | rolling KV cache | 训练直接面对自身误差分布 | 训练代价与系统主张需逐配置复现 |
矩阵中的“2025”同时包含首发年和正式发表年一致的工作;若二者不一致,应像 FramePack 一样分开记录。论文名旁的年份不是“技术被发明的唯一时刻”,而是本章可核验的版本节点。
5. 评测项目
VP0:单步/短期视觉保真
固定相同 resolution、FPS、color range、crop 和 horizon,报告 PSNR/SSIM(失真)、LPIPS(感知),必要时补 motion/flow consistency。它们回答“与这一条 GT 多像”,不回答“是否覆盖其他可能未来”。PSNR 更高而图像更糊并不矛盾。
VP1:多步 open-loop 稳定性
让模型在第一个预测之后只吃自己的输出,按 horizon 曲线报告而非一个平均数:
- metric-vs-time 与 bootstrap confidence interval;
- time-to-failure、首个 identity/state/topology violation;
- 物体永久性、遮挡后重现、相机运动与边界连续性;
- block boundary、context eviction 和重编码时刻的分段误差。
必须同时给 teacher-forced one-step 与 self-conditioned rollout;否则无法判断改进来自模型本身,还是测试时持续喂 GT。
VP2:条件分布、覆盖与校准
对每个前缀采样 \(K\) 次,报告 \(K\)、seed 和 sampling temperature。可组合:
- sample-average distortion 与 best-of-\(K\);后者是 oracle,\(K\) 越大通常越占优;
- conditional FVD/KVD 或 feature-distribution distance;
- diversity under fixed prefix 与同一模型的 unconditional diversity 分开;
- event/state 的 coverage、precision、Brier score、NLL 或 empirical coverage;
- human pairwise preference,但要随机次序、盲测并报告受试者数/区间。
FVD 只有在 feature extractor、clip length、FPS、resolution、preprocessing 与样本数完全一致时才可横向比较。单条真实未来不可能独自证明多峰分布是否正确。
VP3:OOD、反事实与干预
把外观 shift 与 dynamics shift 分开:新纹理/背景、未见速度/碰撞参数、长尾事件、动作序列、相机扰动。对 action-conditioned 模型执行 matched-state action swap,检查预测差异是否与真实干预后果一致。只在自然视频上“看起来物理”仍属于观察性证据。
VP4:闭环 utility
把预测接入同一 planner/policy,在真实或可信 simulator 中比较 success、return、planning regret、collision/constraint violation、latency 与 compute。控制变量至少包括 encoder、planner 搜索预算、action horizon 和真实观测重规划频率。只有这一层能直接支持“对决策有用”。
6. 数据与划分
- 相邻片段泄漏:同一原视频切出的相邻 clip 分散在 train/test,背景和演员几乎重复;应按 source video、scene 或 episode 分组切分。
- FPS 偷换:同样预测 16 帧,在 4 FPS 与 25 FPS 上代表完全不同时间跨度;必须同时报告帧数和秒数。
- 未来条件泄漏:双向 encoder、光流预计算、全片段 normalization、未来 caption/trajectory 或 cache 可能泄漏 \(Y\)。
- 动作对齐:动作究竟作用于 \(x_t\rightarrow x_{t+1}\) 还是前一间隔必须写明;控制频率与视频 FPS 不同时需给 resampling 规则。
- 随机 crop 改变物理:裁剪可让对象“凭空消失”,水平翻转可能改变驾驶/文字语义;增强需要按任务审计。
- 压缩和去重:测试集近重复、不同 codec/bitrate 或关键帧结构会改变低层指标;需 source-level dedup 和解码版本记录。
- 可变长度挑样:只展示幸存的长样本会形成 survivorship bias;预注册停止条件,并保留所有失败 rollout。
- 模型选择泄漏:在 test FVD 上挑 checkpoint、guidance、temperature 或 best seed 等同调参;应有 validation split。
- 不等价算力:diffusion step、sample 数 \(K\)、context length、cache、分辨率与硬件都影响质量和速度;同时报告端到端延迟、吞吐和峰值显存。
7. 故障诊断
| 失败模式 | 可观察症状 | 优先诊断 | 反证实验 |
|---|---|---|---|
| 均值模糊 | 多个运动方向被平均 | 点估计 + L2 是否面对多峰未来 | 改为 \(K\) 样本并测 coverage,而非只换锐化器 |
| 自回归漂移 | 颜色、身份、尺度逐步偏移 | train–test forcing gap 与重编码误差 | teacher-forced 与 self-conditioned 曲线对照 |
| 物体永久性失败 | 遮挡后对象消失或换身份 | context eviction、memory retrieval | 延长遮挡并控制外观相似 distractor |
| 冻结/运动坍缩 | 镜头变静、背景保持但动作停止 | 静态重建奖励或 mode collapse | 按运动幅度分层,测 trajectory/flow |
| 幻觉细节 | 锐利纹理不受历史支持 | perceptual/adversarial/guidance 过强 | mask 历史线索,检查条件敏感性 |
| 块边界跳变 | 每 \(b\) 帧出现相位/亮度突变 | block AR、overlap 和 cache reset | 按 block boundary 对齐绘制误差 |
| 动作忽略 | 换动作后未来几乎不变 | policy bias、condition dropout | matched prefix 的 action swap |
| 时间捷径 | 预测复制最后一帧仍得高分 | 数据静态比例、短 horizon | motion-stratified baseline 与 copy-last |
| 不确定性失真 | 样本多样但事件频率错误 | temperature、posterior/prior gap | reliability diagram 与 held-out event frequency |
| metric hacking | best-of-\(K\) 很好,平均样本很差 | oracle selection | 固定 \(K\),同时报告 average、best 与 compute |
8. 技术发展
一个工作只有满足下列判据才进入主里程碑:它改变了任务定义、表示/概率建模、rollout/forcing 或证据层级之一;有可定位的一手版本;后续工作仍可明确继承或反驳该变化。单纯更大模型、精选 demo 或不可比的单项 SOTA 不构成里程碑。
| 时间 | 可核验节点 | 判据对应的变化 |
|---|---|---|
| 2015 | ConvLSTM;Scheduled Sampling [1], [7] | 空间递归状态;首次系统处理训练/生成输入错配 |
| 2016 | Beyond MSE;DNA/CDNA/STP [2], [3] | 从像素均值损失转向感知/对抗;显式变换像素 |
| 2018 | SV2P;SVG-LP [5], [6] | 将多未来写成 history-conditioned latent distribution |
| 2019 | PlaNet [9] | latent prediction 通过 online planning 接受 utility 检验 |
| 2021 | VideoGPT;FitVid [10], [11] | token AR 与强简化基线;二者正式 venue 状态需分别记录 |
| 2022 | SimVP;Video Diffusion Models;MCVD [12], [13], [14] | 简单架构对照;score-based future;mask 统一多视频条件任务 |
| 2024 | Diffusion Forcing [15] | token-specific noise 统一因果生成、rolling 与 guidance |
| 2025 | NOVA、CausVid、FramePack、Self Forcing [16]-[19] | 连续 token AR、因果蒸馏、固定预算历史、rollout-aligned training |
| 2026 | PHANTOM、trajectory prediction、Causal Forcing 与新预印本前沿 [21], [22], [25] | 联合物理状态、先预测动力学轨迹、正式因果扩散训练;长期记忆/4D reward 仍在快速验证 |
9. 近期方法
9.1 已有正式 proceedings 的方向
PHANTOM 联合推断/预测 latent physical state 与未来 RGB,发表于 CVPR 2026;它把“物理变量是否正确”加入像素之外的显式接口,但论文 benchmark 仍不能推出任意真实世界物理泛化 [21]。Envisioning the Future, One Step at a Time 用自回归 diffusion 先预测稀疏 point trajectories,并在 OWM 上生成多样长轨迹,发表于 CVPR 2026;它代表“先预测动力学结构,再渲染外观”的证据路线 [22]。PhysInOne 则把短/长期 future frame、物理属性与迁移放在同一视觉物理 suite 中,为协议统一提供正式基准 [23]。
Causal Forcing 也已有 ICML 2026 正式接收页;它强调 causal teacher/ODE initialization 与自回归生成分布的匹配,不再按只有 arXiv 的前沿计算 [25]。
9.2 截止冻结日仍为预印本的前沿
- 训练期未来监督而非推理泄漏:Video-Mirai 用 frozen non-causal foresight encoder 从完成 rollout 构造 stop-gradient target,部署结构保持因果 [24]。
- 分钟级记忆:Ring Forcing 针对 object permanence 与 memory capacity,让模型训练时从环形时间结构检索远距信息;其分钟级一致性是 2026-08-27 新预印本的作者结果,尚无正式 venue [26]。
- 避免静态奖励冻结运动:Stream4D 以 feed-forward 4D reconstruction reward、motion prior 和 perceptual anchor 优化自回归 diffusion;截至冻结日是 2026-08-20 预印本 [27]。
- 显式动力学分布:GARFIELD 将 scene kinematics 写成可查询 latent distribution,可接受稀疏约束;这比单条像素续写更接近可校准 future state。其 arXiv 页由作者标注“accepted to ECCV 2026”,但截至冻结日未核到对应的正式 proceedings/会议页,因此本章仍按 E2 预印本处理 [28]。
- representation-first rendering:Re2Pix 先预测 foundation representations,再条件生成像素,直面 GT representation 与 predicted representation 的 train–test gap;截至冻结日仍是预印本 [29]。
- 时间抽象:SUNTA 以 surprise 触发 nested temporal abstraction,作者报告超训练长度 rollout;需要统一协议下复核 memory、compute 和失败尾部 [30]。
这组工作共同把前沿从“下一帧更清楚”推向四个可检验问题:远距状态是否可检索、运动是否被静态画质奖励压死、预测 representation 是否能被稳定渲染、训练期 foresight 是否真正不泄漏到部署。它们不是同一排行榜,也不应把 arXiv 日期写成正式发表 venue。
10. 实验设计示例
本节是可按任务调整的实验设计示例,尚未在本仓库运行;参数与阈值是示例设置,不是已发布基准或实测结果。
10.1 实验规格
input:  B x Tc x 3 x H x W, RGB, [0,1], fps=..., seconds=Tc/fps
target: B x Th x 3 x H x W; train-only supervision allowed; never deployment input
extra:  actions? timestamps? text? camera? declare every condition
model:  pixel/latent/token; deterministic/stochastic; frame/block b=...
train:  forcing policy; loss; corruption/posterior/teacher/target paths; augmentations
test:   self-conditioned; context update; K; seed; steps; guidance
report: horizon curves; distribution metrics; failure tail; latency/VRAM
split:  source-video/scene/episode grouped; duplicates audited
10.2 声明与最低证据
| 想写的结论 | 最低验收门 |
|---|---|
| “短期预测更准” | 同协议 VP0 指标、置信区间、copy-last/SimVP 类强基线 |
| “长 rollout 更稳” | VP1 self-conditioned horizon curve、time-to-failure、所有样本 |
| “能表达多未来” | 固定 \(K\) 的 VP2 coverage/calibration,加 average 与 best-of-\(K\) |
| “理解物理” | state/trajectory probe,加 dynamics OOD 与受控 intervention |
| “是 world model” | 明确 action/reward/state 规格,加 VP4 closed-loop utility |
| “实时/流式” | 因果输出顺序、端到端首帧/稳态延迟、硬件、步数、峰值显存 |
最后的审稿问题只有一句:如果把所有未来真值、精选 seed 和视觉修辞拿走,模型还能在自己的状态分布上保持正确,并为可重复的预测或决策带来收益吗?
资料版本
手册结构修订:2026-09-20。原资料覆盖日期:2026-08-30。动态资源状态以条目日期和官方入口为准;未标注本仓库复现的实验数字均按其引用来源理解。
参考文献
[1] Convolutional LSTM Network: A Machine Learning Approach for Precipitation Nowcasting. Xingjian Shi et al. NeurIPS. 2015.
[2] Deep multi-scale video prediction beyond mean square error. Michael Mathieu, Camille Couprie, Yann LeCun. ICLR. 2016.
[3] Unsupervised Learning for Physical Interaction through Video Prediction. Chelsea Finn, Ian Goodfellow, Sergey Levine. NeurIPS. 2016.
[4] Deep Predictive Coding Networks for Video Prediction and Unsupervised Learning. William Lotter, Gabriel Kreiman, David Cox. arXiv:1605.08104; ICLR conference version. 2017.
[5] Stochastic Variational Video Prediction. Mohammad Babaeizadeh et al. ICLR. 2018.
[6] Stochastic Video Generation with a Learned Prior. Emily Denton, Rob Fergus. ICML. 2018.
[7] Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks. Samy Bengio et al. NeurIPS. 2015.
[8] Deep Kalman Filters. Rahul G. Krishnan, Uri Shalit, David Sontag. arXiv:1511.05121. 2015.
[9] Learning Latent Dynamics for Planning from Pixels. Danijar Hafner et al. ICML. 2019.
[10] VideoGPT: Video Generation using VQ-VAE and Transformers. Wilson Yan et al. arXiv:2104.10157. 2021.
[11] FitVid: Overfitting in Pixel-Level Video Prediction. Mohammad Babaeizadeh et al. arXiv:2106.13195 / CoRR. 2021.
[12] SimVP: Simpler Yet Better Video Prediction. Zhangyang Gao et al. CVPR. 2022.
[13] Video Diffusion Models. Jonathan Ho et al. NeurIPS. 2022.
[14] MCVD - Masked Conditional Video Diffusion for Prediction, Generation, and Interpolation. Vikram Voleti, Alexia Jolicoeur-Martineau, Christopher Pal. NeurIPS. 2022.
[15] Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion. Boyuan Chen et al. NeurIPS. 2024.
[16] NOVA: Autoregressive Video Generation without Vector Quantization. Zhengcong Fei et al. ICLR. 2025.
[17] From Slow Bidirectional to Fast Autoregressive Video Diffusion Models. Tianwei Yin et al. CVPR. 2025.
[18] Frame Context Packing and Drift Prevention in Next-Frame-Prediction Video Diffusion Models. Lvmin Zhang et al. NeurIPS. 2025. arXiv version history.
[19] Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion. Xuan Yang et al. NeurIPS. 2025.
[20] V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning. Mahmoud Assran et al. arXiv:2506.09985. 2025.
[21] PHANTOM: Physics-Infused Video Generation via Joint Modeling of Visual and Latent Physical Dynamics. Ying Shen et al. CVPR. 2026.
[22] Envisioning the Future, One Step at a Time. Stefan Andreas Baumann et al. CVPR. 2026.
[23] PhysInOne: Visual Physics Learning and Reasoning in One Suite. Siyuan Zhou et al. CVPR. 2026.
[24] Video-Mirai: Autoregressive Video Diffusion Models Need Foresight. arXiv:2606.03971. 2026.
[25] Causal Forcing: Autoregressive Diffusion Distillation Done Right for High-Quality Real-Time Interactive Video Generation. ICML. 2026. arXiv:2602.02214.
[26] Ring Forcing: Towards Precise Long-Term Memory for Autoregressive Video Diffusion. arXiv:2608.26794. 2026.
[27] Stream4D: 4D-Consistency for Streaming Autoregressive Diffusion Video Models. arXiv:2608.19556. 2026.
[28] Schrödinger's Cat: Probabilistic Representation and Prediction of Potential Scene Kinematics. arXiv:2607.25984. 2026.
[29] Representations Before Pixels: Semantics-Guided Hierarchical Video Prediction. arXiv:2604.11707. 2026.
[30] SUNTA: Hierarchical Video Prediction with Surprise-based Chunking. arXiv:2607.02087. 2026.