Test-Time Scaling 章节调研与证据记录
链接维护:2026-10-15 校正一手入口;除明确注明的链接解析状态外,正文研究结论与发布状态仍按原记录日期理解。
调研快照:2026-09-02(Asia/Shanghai) 对应正文:
docs/generative-models/test-time-scaling.md
1. 研究问题
本轮调研服务于一个明确问题:怎样为 Video Generation 101 新增 test-time scaling 专章,同时不把以下相邻概念混写:
- 多候选 Best-of-\(N\) 与中间去噪轨迹搜索;
- 推理期 reward guidance、latent / noise 优化与临时参数适配;
- 长视频分块、流式闭环和输出长度增长;
- 视频推理中的 pass@\(k\)、生成视频作为“想象”以及基础视频质量;
- 推理加速、后训练与真实部署成本;
- 搜索 verifier 与独立 evaluator。
最终采用“预算投向 × 反馈位置 × 候选处理 × 访问条件”的主题式组织,而不是逐篇论文摘要。
2. 检索范围与方法
2.1 时间与来源
- 重点窗口:2025-01-01 至 2026-09-02;
- 正式论文优先:CVF Open Access、NeurIPS Proceedings、ICLR Proceedings、BMVC Proceedings、TMLR / OpenReview、ACM DOI;
- 最新进展:arXiv 摘要页、作者项目页;
- 技术主张只采用论文或官方元数据,不用二手新闻替代;
- 预印本的“已接收”若只有作者备注支撑,正文写成“作者注明”,不升级为独立验证。
2.2 查询族
"test-time scaling" video generation"inference-time scaling" text-to-videovideo diffusion latent search verifiervideo generation Best-of-N rewardtest-time optimization compositional video generationstreaming video generation test-time scalingvideo generation candidate recyclingvideo diffusion noise trajectory optimizationlatent reward model video generationjoint audio video inference-time scaling
2.3 纳入标准
纳入正文时间线的工作至少满足一项:
- 直接在视频生成输出上分配可变推理预算;
- 在视频 diffusion / flow 的中间状态做搜索、剪枝或优化;
- 用 verifier、reward、world model 或生成器内部信号改变候选选择;
- 明确研究长视频、流式视频或联合音视频的 inference-time scaling;
- 专门训练支持“更多 NFE 仍可改善”的视频模型,用于厘清深度 scaling 边界。
排除或只作边界说明:
- 只做图像实验、仅声称可推广到视频的方法;
- 只增加生成长度而不研究固定任务的质量—成本曲线;
- 使用真值测试指标挑选候选的 oracle 结果;
- 生成视频只作为下游推理中间变量、最终不评价视频质量的工作;
- 传统推理加速、蒸馏、量化或缓存,但没有把节省预算再分配给质量提升的工作。
3. 证据等级
| 等级 | 定义 | 正文写法 |
|---|---|---|
| A | 正式会议/期刊页面或 DOI 可核验 | 可写正式 venue;数值仍标为作者报告,除非有独立复现 |
| B | arXiv 预印本或仅作者项目材料 | 明确写“预印本”或“作者注明” |
| C | 开放代码、项目页或演示 | 只支撑工件可见性,不单独证明效果 |
| S | 本章基于多篇工作的综合归纳 | 写成“本章建议/本章归纳”,不伪装成论文共识 |
4. 纳入证据矩阵
| # | 工作 | 首次公开 / venue | 直接支撑的分类 | 等级 | 主来源 |
|---|---|---|---|---|---|
| 1 | DLBS | 2025-01;NeurIPS 2025 | latent beam search、lookahead、reward 校准 | A | NeurIPS |
| 2 | ScalingNoise | 2025-03;预印本 | 噪声候选、锚帧 reward、无限视频 | B | arXiv |
| 3 | Video-T1 | 2025-03;ICCV 2025 | 线性 Best-of-\(N\)、Tree-of-Frames | A | CVF |
| 4 | EvoSearch | 2025-05;预印本/公开项目 | 选择、变异、交叉、多样性 | B/C | arXiv |
| 5 | The Verifier Matters | BMVC 2025 | 早期带噪状态的 verifier 校准 | A | BMVC |
| 6 | Improving Video Generation with Human Feedback / Flow-NRG | NeurIPS 2025 | inference-time reward / energy guidance | A | NeurIPS |
| 7 | TiViBench / VideoTPO | CVPR 2026 | 候选自分析;与 video reasoning 的边界 | A | CVF |
| 8 | TTOM | ICLR 2026 | 临时参数优化、参数化记忆 | A | ICLR |
| 9 | Inference-Time Scaling for Joint Audio-Video Generation | TMLR 2026 | 多 verifier、自适应 reward 权重 | A | OpenReview |
| 10 | WMReward | CVPR 2026 | latent world-model reward、物理引导 | A | CVF |
| 11 | LatSearch | 2026-03;预印本,作者注明 ECCV 2026 | 任意噪声时刻 latent reward、剪枝 | B | arXiv |
| 12 | Stream-T1 | 2026-05;预印本 | 分块搜索、长短窗口 reward、缓存 | B | arXiv |
| 13 | AnyFlow | 2026-05;预印本 | 支持 NFE 深度 scaling 的专门训练 | B | arXiv |
| 14 | Proprio | 2026-05;预印本 | 冻结生成器自评分、BoN、梯度 refinement | B | arXiv |
| 15 | PRISM | 2026-06;预印本 | 带噪 latent reward,避免完整解码 | B | arXiv |
| 16 | TANGO | 2026-07;预印本 | 自诊断、测试时 LoRA | B/C | arXiv · 项目页 |
| 17 | VISTA | CVPR 2026 | 黑盒 Agent 规划—生成—批评—重写 | A | CVF |
| 18 | CachedSearch | 2026-07;预印本 | 低成本缓存探索、完整重生成赢家 | B/C | arXiv · 项目页 |
| 19 | GEARS | ACM TOG / SIGGRAPH Asia 2026 | 诊断、修复、淘汰与候选回收 | A | arXiv;相关 DOI 10.1145/3842526 保留,2026-10-15 解析返回 404;作者稿注明已接收 |
| 20 | NoisEasier | 2026-08;预印本 | 可微 reward 引导的完整噪声轨迹优化 | B | arXiv |
5. 关键综合结论
5.1 分类不是互斥论文桶
同一系统可能同时包含候选宽度、轨迹深度、reward guidance、临时参数更新和多轮 Agent。更稳定的描述方式是写出:
例如,GEARS 是“多候选宽度 × 关键帧/多维 reward × 诊断修复回收 × 可编辑 prompt/latent × 视频质量”;VISTA 是“多轮生成 × 外部批评 × 提示重写 × 黑盒模型访问 × 系统级人类偏好”。
5.2 scaling 的必要条件
- proposal 随预算增加能产生有价值的差异;
- verifier 的排序信息大于噪声,并能迁移到新增候选;
- 调度器把预算投向高边际收益区域;
- 独立 evaluator 或人评能确认收益;
- 增益大于额外生成、验证和优化成本。
任何一项失效,质量—预算曲线都可能饱和或反转。
5.3 2025—2026 的演进
- 完整视频 Best-of-\(N\) → 中间 latent / 关键帧提前决策;
- 均匀扩宽 → beam、Successive Halving 与难度感知调度;
- 外部 reward → latent reward、world model 和生成器内部自评分;
- 丢弃低分候选 → 缓存探索、局部修复与候选回收;
- 单目标视频 → 物理、长时序、流式和联合音视频多目标;
- 固定 sampler trick → 临时 latent、noise、LoRA、memory 和 Agent 状态更新。
6. 负向边界审计
6.1 不应纳入直接视频实证
Inference-Time Scaling for Flow Models via Stochastic Generation and Rollover Budget Forcing 声称方法可推广到视频,但公开论文实验是图像生成。本章不把它列成视频生成实证。
6.2 世界模型搜索的三种不同目标
- 直接改善生成视频:WMReward 的 latent world model 直接评价候选轨迹,纳入正文;
- 视频作为下游推理的想象:MindJourney、AVIC 等最终评价空间推理或问答,应主要放在 Video Reasoning;
- 动作规划中的 imagined rollout:PlaNet、GRASP、HWM 等最终评价控制成功率,只可作为概念来源,不可替代视频质量证据。
6.3 Oracle 与真实选择器
用 ground-truth、最终 benchmark 或事后人评挑选候选,只能估计候选池上界。正文要求同时报告随机选择、实际 verifier、oracle 和 regret,避免把不可部署 oracle 写成方法性能。
6.4 “Training-free”与“基础模型冻结”
基础生成器冻结不代表零训练或零更新。必须继续记录:
- verifier / reward model 是否预先训练;
- 是否调用外部 VLM、世界模型或 Agent;
- 是否执行反向传播;
- 是否更新 latent、noise、临时 LoRA 或其他参数;
- memory 是否跨请求保留;
- 状态何时重置,以及是否存在隐私或污染风险。
7. 推荐的最小实验记录
每个结果至少附带:
generator:
sampler:
precision:
resolution:
fps:
duration:
budget:
  candidates:
  generator_nfe_per_candidate:
  verifier_calls:
  backward_steps:
  external_model_calls:
  agent_tokens:
  winner_rerun:
latency:
  mean:
  p95:
  time_to_first_frame:
memory_peak:
search_reward:
independent_metrics:
human_evaluation:
diversity:
selector_regret:
failure_stratum:
random_seeds:
这是本章综合出的记录模板,不是已经被领域统一采用的官方标准。
8. 示意图生成与验收记录
- 最终文件:
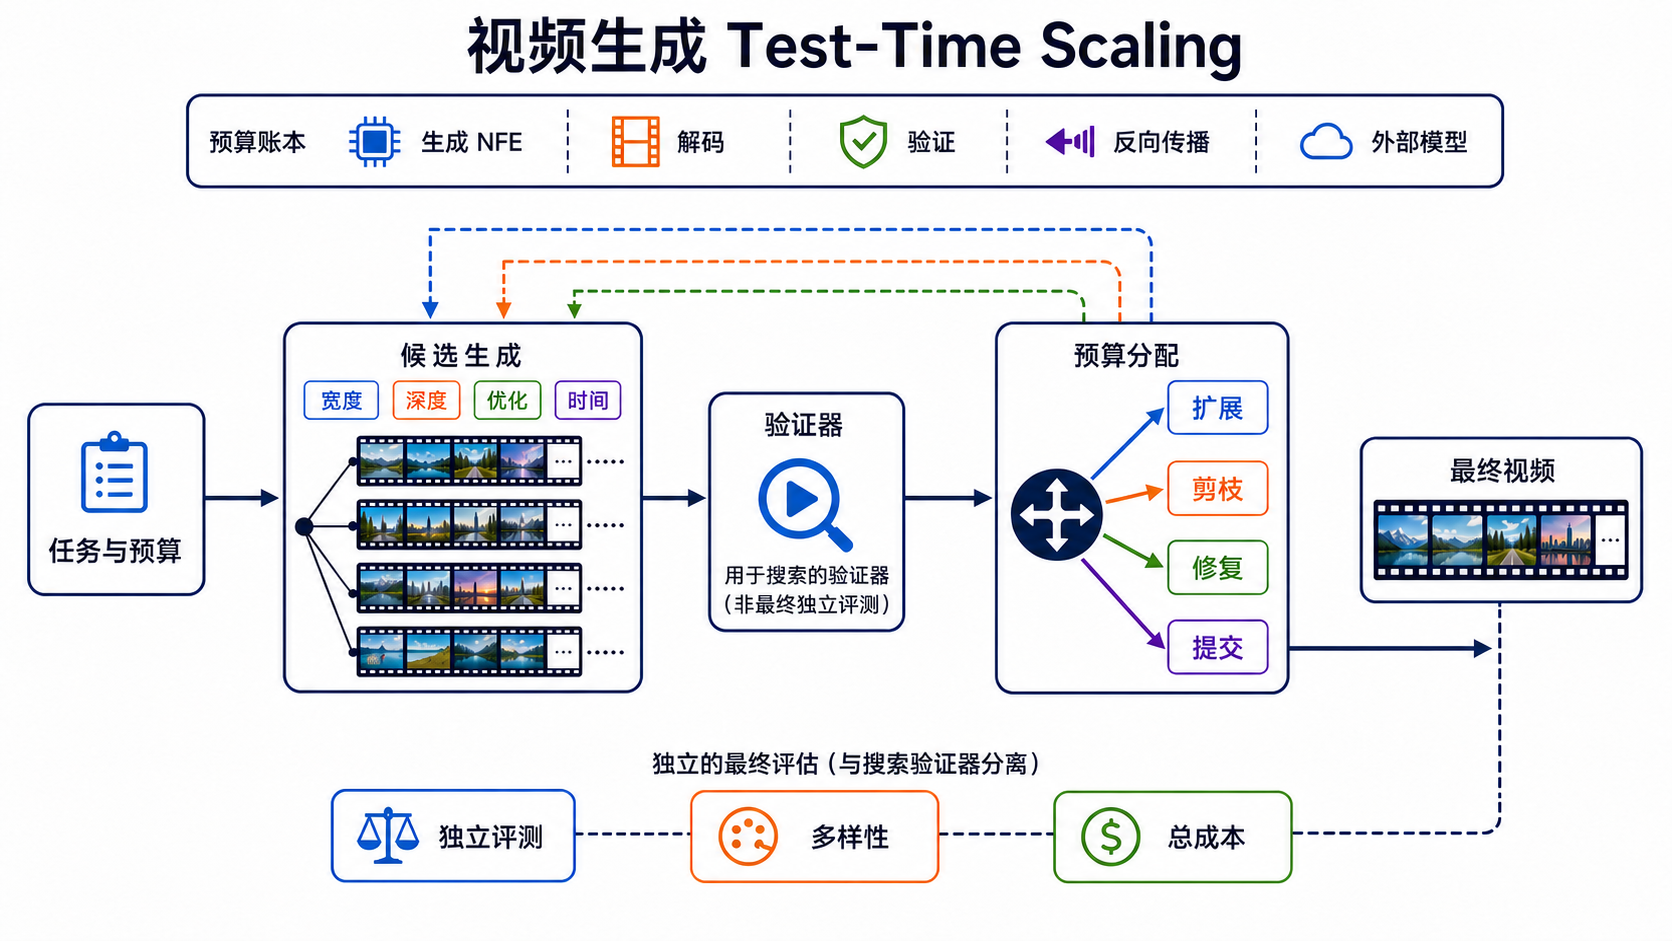
assets/diagrams/video-test-time-scaling-budget-map.png - 生成方式:Codex 内置图像生成;科学示意图专用外部服务因本机未配置其 API key,改用内置生成能力。
- 画布:1672 × 941 PNG,16:9。
- SHA-256:
cfe127fafcb494beae221bfa47d815cd6032a479b801c25b5223f7627895c90e - Prompt 摘要:中文学术信息图;展示任务与预算、候选宽度/深度/优化/时长、验证器、扩展/剪枝/修复/提交、最终视频,以及与搜索信号隔离的独立评测;第二轮只移除独立评测返回任务预算的虚线箭头;白底、深蓝与青色、少文字、无装饰性 logo。
- 视觉检查:已按原分辨率检查中文、连线、裁切、长宽比和页脚成本项;独立评测路径现在终止于报告区,不再反馈搜索;未发现明显乱码、遮挡、水印或错误 logo。
- 语义边界:图只表达决策闭环,不声称某一算法优于另一算法;“独立评测”与“验证器”分开,避免循环评测。
9. 本次未做的事情
- 未把作者报告数值汇总成跨论文排行榜,因为模型、分辨率、时长、NFE、reward 与成本口径不可直接比较;
- 未声称 2026 年预印本已被独立复现;
- 未把 test-time length、推理加速或视频 reasoning 的 pass@\(k\) 直接写成视频生成质量 scaling;
- 未改写中央 bibliography 注册表;本章保留本地、可点击且逐项核验的参考文献,减少对现有未提交改动的冲突。